Un museo de ZFS, leído en su código fuente

Uberblok

El almacenamiento siempre ha tenido los mismos enemigos: discos que mienten, escrituras interrumpidas, una caída en mitad de una actualización. ZFS les hace frente con un puñado de ideas. Este museo las muestra sala a sala, a partir del código que las implementa.

Cada animación remite a líneas de OpenZFS zfs-2.4.4, congelado en el commit 71a9f9578616, y cada extracto enlaza con ellas. Aquí no hay nada dibujado de memoria.

¿Por qué este museo?

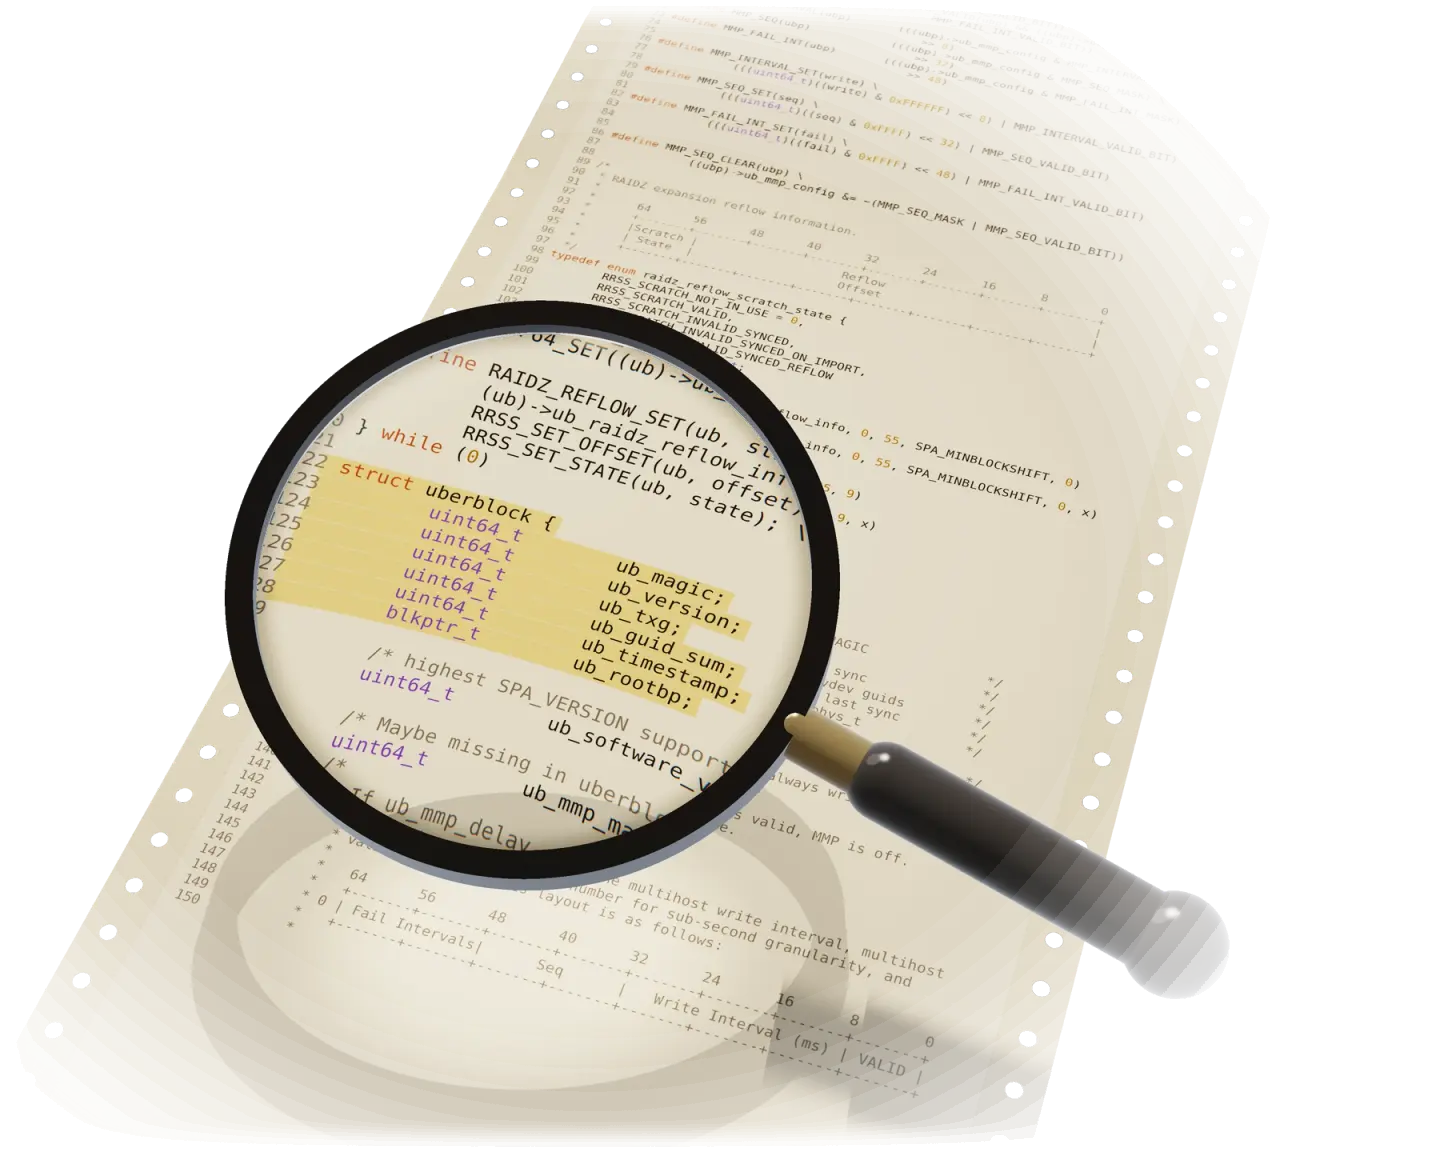
Imagen renderizada de una tira de papel continuo plegado en zigzag, impresa con el archivo de OpenZFS include/sys/uberblock_impl.h, cuyo extremo lejano se desvanece. Una lupa redonda de montura y mango negros, sostenida encima, amplía la declaración resaltada de struct uberblock: uint64_t ub_magic, ub_version, ub_txg, ub_guid_sum, ub_timestamp y blkptr_t ub_rootbp destacan, más grandes que las líneas de alrededor. La lupa proyecta sobre el papel una sombra suave, con un punto de luz.

Fig. 1. El objeto del Vestíbulo bajo la lupa: struct uberblock, líneas 122 a 128 de include/sys/uberblock_impl.h en zfs-2.4.4, impresas con las líneas 36 a 150 del archivo.

  1. struct uberblock: el registro que nombra todo el pool
  2. ub_txg: el grupo de transacciones de la última sincronización
  3. ub_rootbp: el puntero de bloque a la raíz del árbol, el MOS
  4. El listado: las líneas 36 a 150 del archivo, numeradas como en la fuente

El objeto del Vestíbulo: el uberblock

Un pool son millones de bloques repartidos en varios discos. Tras una caída, el sistema debe encontrar su estado actual y coherente sin recorrer ninguno de ellos. Por eso un pequeño registro nombra la raíz de todo: el uberblock. Contiene un número de grupo de transacciones, ub_txg, y un puntero de bloque, ub_rootbp; desde ese puntero se llega a todos los demás bloques del pool.

Cada disco lleva cuatro etiquetas, dos al principio y dos al final, y cada etiqueta guarda un anillo de 128 KiB de uberblocks. Un uberblock nuevo nunca sobrescribe el anterior: el uberblock del txg N va a la ranura N módulo el número de ranuras (con multihost=on, la última ranura se reserva para MMP y el anillo gira sobre una ranura menos). Al importar, ZFS lee todas las ranuras de todas las etiquetas y se queda con el uberblock válido con el txg más alto.

Se suele decir que el anillo contiene 128 uberblocks. Ocupa 128 KiB: una ranura ocupa un sector, con un mínimo de 1 KiB y un máximo de 8 KiB, así que hay 128 ranuras con sectores de 512 bytes, 64 con ashift 11, 32 en los discos actuales de sectores de 4K, 16 más allá. Cambia el tamaño del sector y observa cómo los txg siguientes van ocupando sus ranuras uno tras otro.

txg 4211
ub_magic
0x00bab10c
ub_txg
4211
ub_rootbp
→ MOS

Anillo de 32 ranuras de 4 KiB (ashift 12). El uberblock del txg 4211 es el más reciente: ranura 19, porque 4211 mod 32 = 19. El uberblock del txg 4210 sigue intacto en la ranura 18.

Todo uberblock empieza por el mismo número mágico, 0x00bab10c: «oo-ba-bloc».

Plano de la visita

Las salas siguen a los datos: la raíz y el árbol, cómo cambia el árbol, dónde caen los bloques, lo que el árbol hace posible, después las funcionalidades construidas sobre él, y la sala de máquinas, donde el museo cuenta cómo se hizo.

  1. Vestíbulo: el uberblock El único registro que designa todo el pool, y el anillo que lo guarda.
  2. Ala de la historia De las primeras líneas de código a OpenZFS, cada hecho con su fuente.
  3. El árbol y el uberblock Punteros de bloque hasta el fondo, y la escritura que convierte un árbol nuevo en el actual.
  4. Copia en escritura, sumas de comprobación y autorreparación Por qué un pool se mantiene coherente sin fsck, y cómo desenmascara a un disco que miente.
  5. Grupos de transacciones Abierto, en cierre, en sincronización: cómo miles de escrituras se convierten en una sola confirmación.
  6. Los vdevs Espejo, raidz, draid, log, cache, special: el árbol de dispositivos bajo un pool.
  7. RAID-Z Bandas de ancho variable, y por qué no hay agujero de escritura.
  8. Instantáneas y clones Fechas de nacimiento y deadlists: ¿a qué instantánea pertenece este bloque?
  9. El ARC Una caché que aprende de lo que olvidó.
  10. Metaslabs y space maps Encontrar espacio libre deprisa, con un registro de asignaciones que solo crece.
  11. ZIL y SLOG El camino de una escritura síncrona.
  12. send / receive Un dataset como flujo, y el incremento entre dos instantáneas.
  13. Compresión, deduplicación, cifrado Tres transformaciones en el pipeline de escritura, y el coste real de la deduplicación.
  14. Sala de máquinas Cómo se construyó este museo, y a partir de qué commit.

Dedicatoria

¿Por qué este museo?

Mantener los datos a salvo es un trabajo crítico, y que rara vez se ve. A un sistema de archivos se le confía todo lo que la gente guarda, y tiene que seguir siendo correcto a pesar de las caídas, los discos que fallan y las escrituras interrumpidas. Uno de los principios sobre los que se diseñó ZFS, en palabras de Bill Moore: never, ever trust the underlying hardware. (no confiar jamás, bajo ningún concepto, en el hardware subyacente; traducción nuestra)1

Este museo rinde homenaje a esa obra de ingeniería, y a las personas que la construyeron. Jeff Bonwick dirigió el desarrollo de ZFS, con Bill Moore como codirector;1 Matt Ahrens fue uno de sus dos autores originales.2 El trabajo comenzó en 2001 con dos ingenieros de Sun Microsystems3 y ZFS se integró en Solaris el 31 de octubre de 2005,4 un paso que Bonwick resumió así: 584 files, 92,000 lines of change, 56 patents, 5 years (584 archivos, 92 000 líneas modificadas, 56 patentes, 5 años; traducción nuestra).4 El 17 de noviembre escribió: I’m incredibly proud of the ZFS team, and deeply grateful: no one person can do something on this scale. (estoy increíblemente orgulloso del equipo de ZFS, y profundamente agradecido: nadie puede hacer por sí solo algo de esta envergadura; traducción nuestra)5

Rinde homenaje, también, a la ingeniería de Sun en aquellos años, en los que los ingenieros publicaban cómo funcionaban sus sistemas: el asignador slab, presentado por Jeff Bonwick en USENIX en 1994;6 DTrace, de Bryan Cantrill, Michael Shapiro y Adam Leventhal, en 2004;7 y el propio código fuente de ZFS, publicado bajo la CDDL como parte de OpenSolaris.3

Y a quienes lo mantienen vivo: OpenZFS, anunciado en 20132 y fundado por miembros de las comunidades de Linux, FreeBSD, Mac OS X e illumos.2 La versión que lee este museo recoge a más de 700 personas en su archivo AUTHORS.
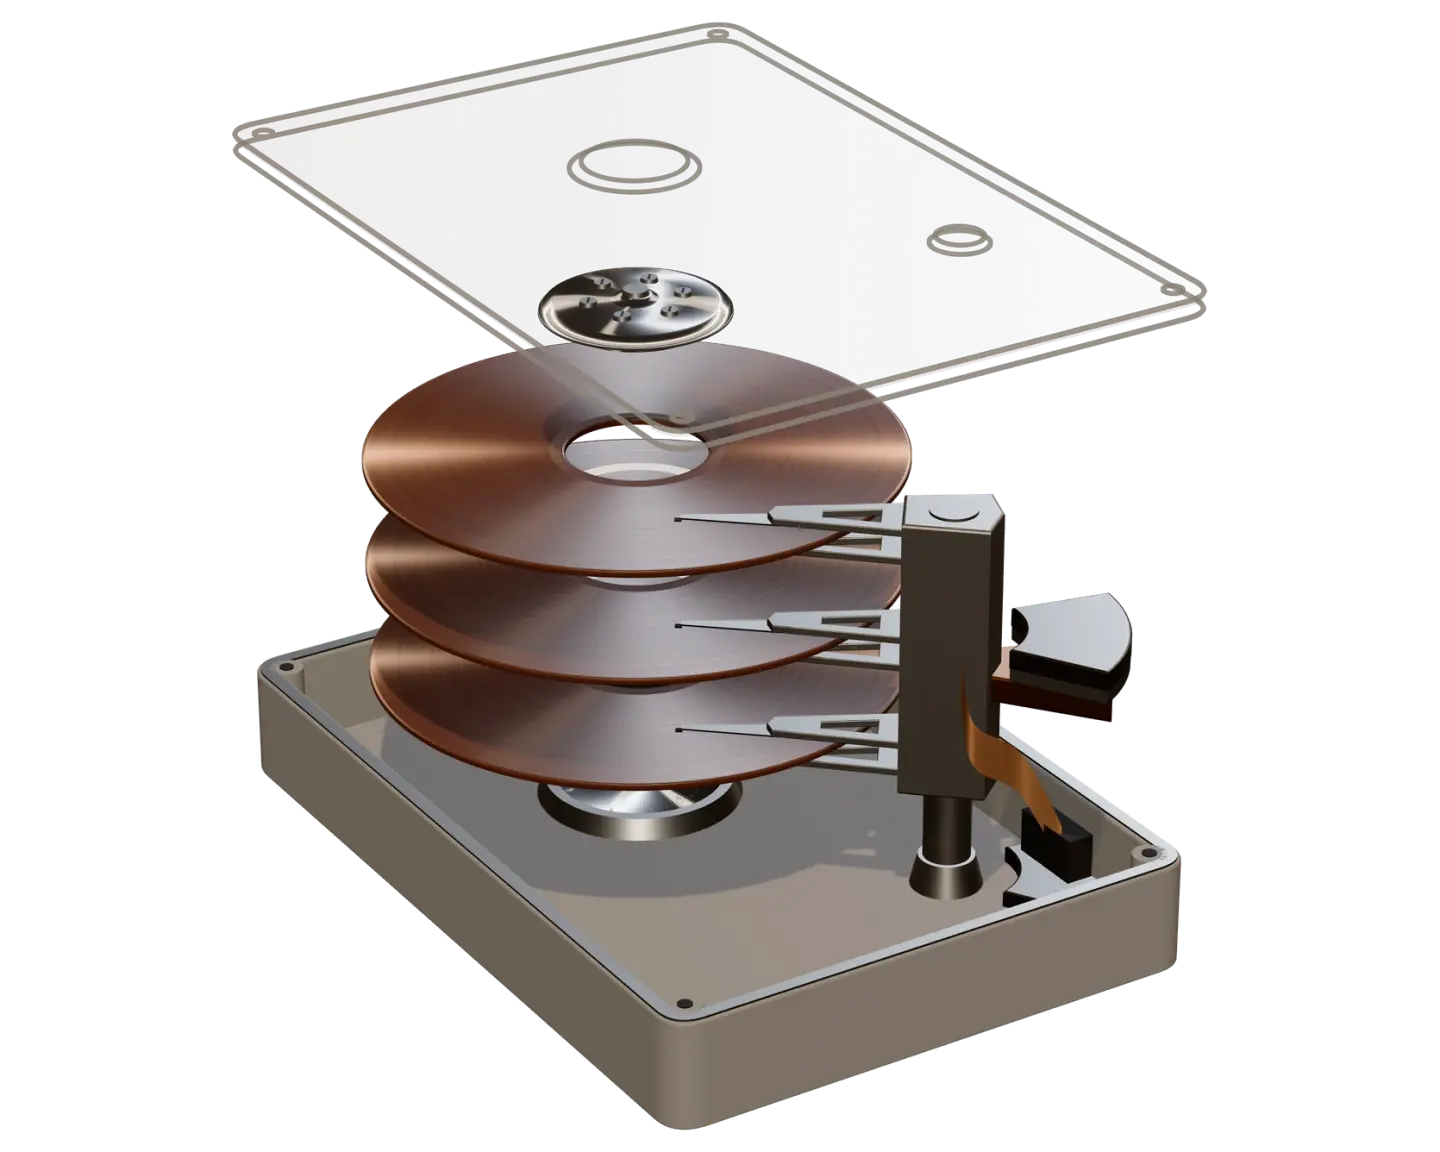
Imagen renderizada de un disco duro desmontado a lo largo de su eje: la base, el motor, tres platos marrones y brillantes, la abrazadera y, en lo más alto, la tapa dibujada solo con su contorno; los brazos del conjunto de cabezales se extienden sobre los platos.

Fig. 2. El hardware subyacente: un disco duro de 3,5 pulgadas, despiezado a lo largo de su eje.

  1. Tapa superior
  2. Abrazadera de los platos
  3. Platos
  4. Conjunto de cabezales: brazos y cabezales
  5. Bobina móvil y su imán
  6. Motor del eje
  7. Chasis

Fuentes

  1. 1 “A Conversation with Jeff Bonwick and Bill Moore”, ACM Queue 5(6), November 2007 (archived 2011-07-16)
  2. 2 OpenZFS launch announcement, open-zfs.org (archived 2013-09-20)
  3. 3 openzfs.org wiki, “History” (archived 2020-05-14)
  4. 4 Jeff Bonwick, “ZFS: The Last Word in Filesystems”, blog post of 31 October 2005 (archived 2007-02-07)
  5. 5 Jeff Bonwick, blog, posts of November 2005, “Thank You” of 17 November 2005 (archived 2006-12-19)
  6. 6 USENIX, abstract of “The Slab Allocator: An Object-Caching Kernel Memory Allocator”, Summer 1994 Technical Conference (archived 2001-02-21)
  7. 7 USENIX, abstract of “Dynamic Instrumentation of Production Systems”, 2004 Annual Technical Conference (archived 2006-01-07)